Jak powstał PolishPal i jak go dziś prowadzę
Od pierwszego commita 18 czerwca 2026 roku po codzienną pracę: rundy fraz, publikację z harmonogramu, odsłuch rodzimej użytkowniczki języka i panel monitoringu.
W skrócie
- Pierwszy commit (18 czerwca 2026) zawiera już lekcje, quizy i zapis postępu, a własny CMS Polaris powstaje dziewięć dni później.
- Artykuły są w bazie Supabase, a zdjęcia w repozytorium jako WebP; codzienne zadanie na serwerze publikuje wpis dopiero po sprawdzeniu każdego zdjęcia.
- Tematy pochodzą z numerowanych rund badania fraz, od 5 listopada z danymi DataForSEO.
- Po odsłuchu rodzimej użytkowniczki języka wszystkie 744 nagrania powstają od nowa, głosem z wymuszonym językiem polskim.
- Content Monitor pilnuje zapasu wpisów, indeksacji w Google, ruchu z Search Console i linków wewnętrznych, a alerty wysyła na Telegram.
- Najwięcej nauki dały wpadki: nieczytelne zdjęcia, podglądy, które się nie budują, za małe zdjęcia główne i nieaktualna strona „O nas”.
PolishPal to darmowy serwis do nauki polskiego po angielsku. Buduję go i prowadzę sam, jako Scentro. Ten tekst opisuje, od czego się zaczęło, na czym to działa i jak wygląda codzienna obsługa: badanie fraz, pisanie, publikacja, kontrola i poprawki. Gotowy produkt pokazuje strona realizacji PolishPal.
Czym jest PolishPal i dla kogo#
PolishPal (polishpal.pl) uczy zupełnie początkujących, od poziomu A0 do A1. Ma 16 krótkich lekcji w ustalonej kolejności, 16 quizów z natychmiastową oceną i 15 tematów gramatycznych z tabelami odmiany. Postęp zapisuje się w przeglądarce, więc nie trzeba zakładać konta.
Przy każdej polskiej kwestii w lekcji jest przycisk z głośnikiem. Stoją za nim 744 gotowe nagrania, a tempo odtwarzania można ustawić od 0,6× do 1,25×.
Obok kursu działa blog z ponad setką artykułów. Odpowiadają na pytania, które ludzie naprawdę wpisują w Google: jak powiedzieć „dziękuję”, czym jest Żabka, jak wygląda Wigilia, co to jest PESEL. Od listopada 2026 roku są też lekcje wideo i Shortsy na YouTubie, zrobione z tych samych materiałów co kurs.
Czytelnicy to osoby anglojęzyczne, które zaczynają polski od zera. Są wśród nich osoby przeprowadzające się do Polski, podróżni i ludzie z polskimi korzeniami. Widać to po tematach bloga: codzienne słowa, urzędowe sprawy dla ekspatów, jedzenie, święta, polskie nazwiska i słownictwo rodzinne.
Jak to się zaczęło#
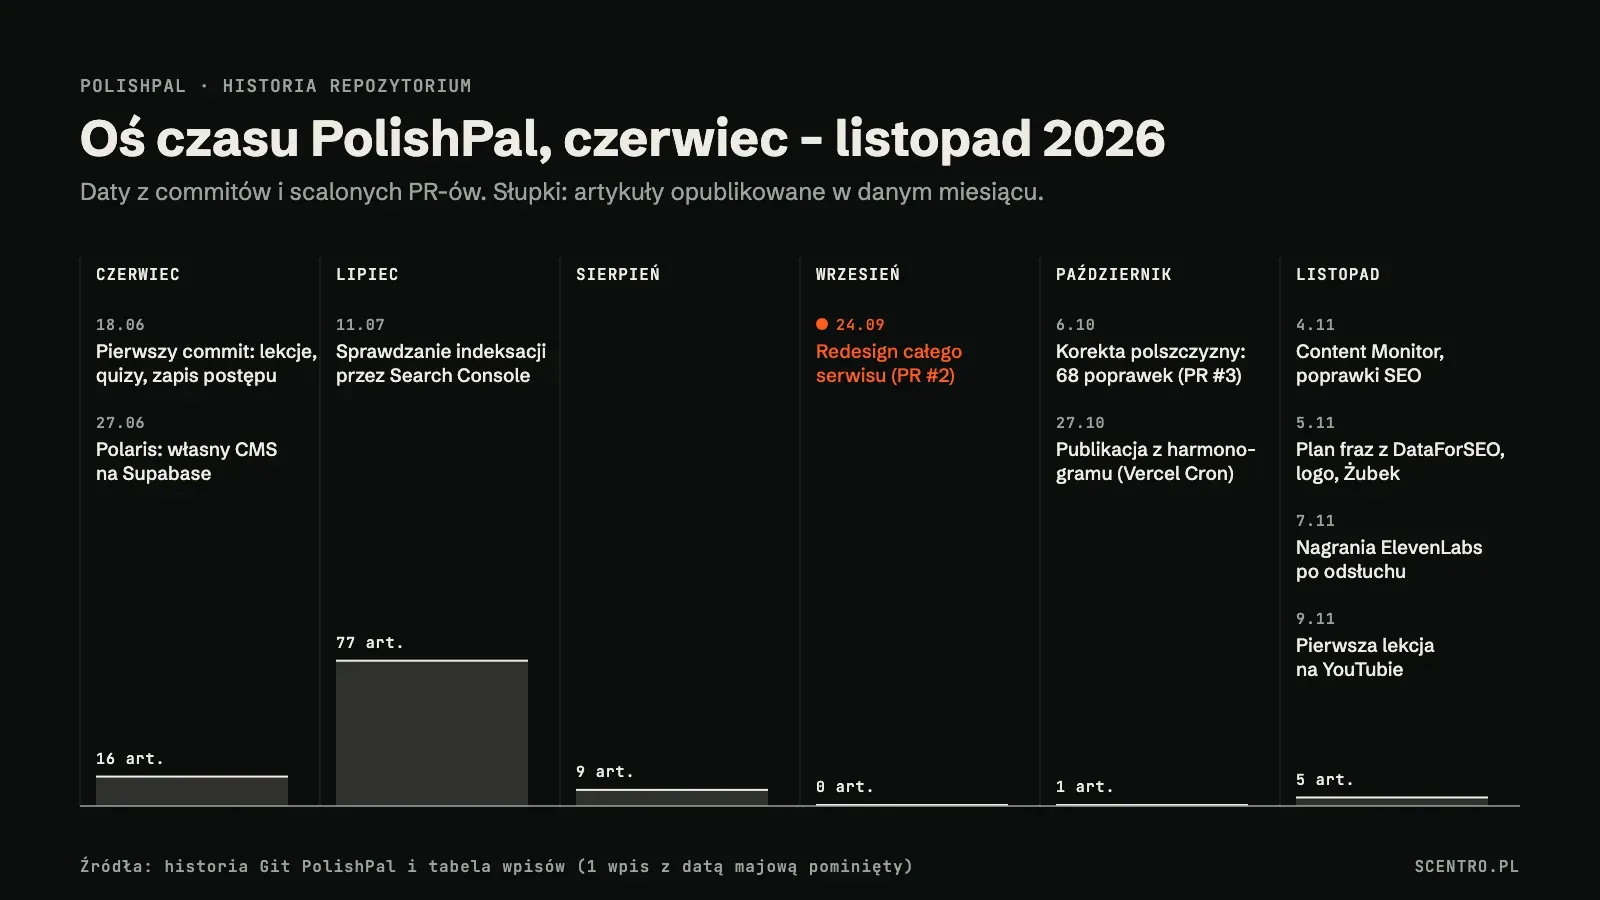
Pierwszy commit ma datę 18 czerwca 2026 roku. Zawiera już rdzeń kursu: strony lekcji, quizy i zapis postępu w przeglądarce, wszystko na Next.js. Tego samego wieczoru dochodzą tematy gramatyczne. W ciągu dwóch kolejnych dni pojawiają się wyszukiwarka, lekcja o podawaniu godziny i przycisk odtwarzania. Na początku mówi on wbudowanym syntezatorem przeglądarki.
Pierwszy tydzień jest intensywny:
- 24 czerwca: tryb ciemny, panel dostępności i przebudowane tabele.
- 25 czerwca: oceny i komentarze na Supabase, mapa strony i plik robots. Serwis przenosi się z domeny polishpal.app na polishpal.pl.
- 26 czerwca: pierwsze wpisy na blogu, jeszcze jako pliki Markdown w repozytorium, oraz spisane zasady pisania.
- 27 czerwca: Polaris, własny CMS wbudowany w serwis. Ma edytor wpisów, panel SEO i podpowiedzi linków wewnętrznych. Od tej chwili artykuły są w bazie danych, a nie w kodzie.
Lipiec to miesiąc pisania: publikuję wtedy 77 artykułów. CMS rośnie razem z nimi. Dostaje automatyczną kopię przed każdym zapisem (5 lipca), powiadomienia IndexNow przy publikacji (7 lipca) i sprawdzanie indeksacji każdej strony przez API URL Inspection w Search Console (11 lipca). Reklamy trafiają wyłącznie na blog, nigdy do lekcji, a statystyki pojawiają się razem z banerem zgody na pliki cookie.
W sierpniu dochodzi dziewięć artykułów. Potem aż do końca października nie ma nowych wpisów, bo trwa praca nad pełnym redesignem. Redesign trafia do głównej gałęzi 24 września. Temu, co stało się potem z ruchem z Google, poświęcam osobny tekst z danymi.
Technologie#
Nie ma tu nic egzotycznego. Chodzi o to, żeby każdy element dało się naprawić samemu.
- Next.js na Vercelu. Strony artykułów są w pamięci podręcznej i odświeżają się najwyżej raz na godzinę.
- Supabase (Postgres) na artykuły, komentarze i oceny. Baza stoi w Sztokholmie, więc funkcje serwerowe serwisu działają w tym samym regionie. Kiedy działały w USA, lista wpisów na blogu ładowała się wyraźnie wolniej.
- ElevenLabs do nagrań po polsku, zapisanych jako statyczne pliki MP3. Gdyby pliku zabrakło, odzywa się syntezator przeglądarki.
- GSAP do Żubka, maskotki w postaci małego żubra. To kukiełka SVG, która porusza ustami w rytm nagrania.
- Resend do newslettera z podwójnym potwierdzeniem zapisu.
- Postiz na własnym serwerze do planowania postów w mediach społecznościowych.
- Google Search Console i DataForSEO jako źródła danych o wyszukiwaniu.
Dużą część kodu i pierwsze wersje tekstów piszą agenci AI. Pracują według zasad zapisanych w repozytorium: przewodnika po pisaniu, listy błędów, których należy unikać, i testów, które muszą przejść. Od września większość zmian trafia do serwisu jako pull requesty z opisem, co się zmieniło i jak to sprawdzono.
System treści#
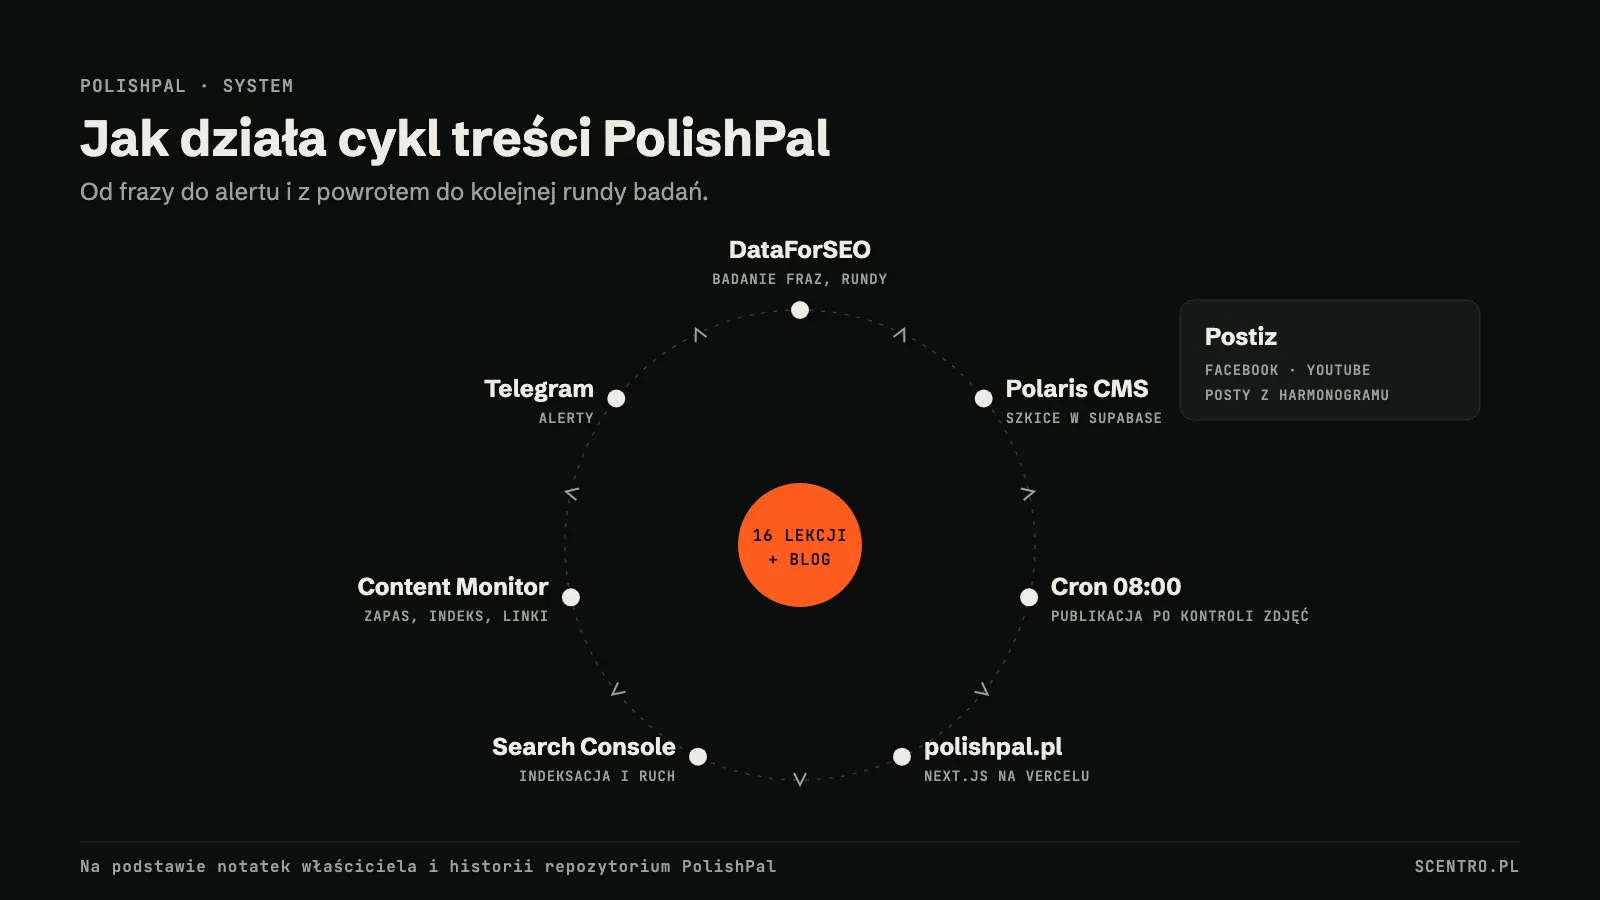
Polaris, czyli CMS#
Każdy artykuł to wiersz w bazie: tytuł, slug, zajawka, opis meta, fraza kluczowa, kategoria, krótkie podsumowanie, tagi i treść w Markdownie. Zdjęcia nie trafiają do CMS-a. Są dodawane do kodu serwisu jako pliki WebP. Treść jest w bazie, zdjęcia w gicie, i od tego podziału zależy cała reszta.
Badanie fraz w rundach#
Tematy pochodzą z numerowanych rund badania fraz. Runda 31, z 5 listopada, jako pierwsza opiera się na liczbie wyszukiwań z DataForSEO, a nie na mojej ocenie popytu. Jedna z wcześniejszych rund poleciła tematy, które już były na blogu. Dlatego każda runda zaczyna się teraz od sprawdzenia opublikowanych wpisów i mapy strony.
Kiedy plan z DataForSEO jest gotowy, 17 wpisów z poprzedniej rundy schodzi z harmonogramu, żeby nowy plan poszedł pierwszy. Szkice zostają w CMS-ie i nic nie jest usuwane.
Harmonogram, który działa beze mnie#
CMS nie ma pola „opublikuj o”. Zamiast tego w repozytorium leży mały plik JSON ze slugami i datami. Codziennie o 8:00 czasu warszawskiego zadanie na serwerze publikuje każdy szkic, którego termin minął.
Najpierw sprawdza, czy każde zdjęcie w artykule jest dostępne i jest poprawnym plikiem WebP. Od listopada sprawdza też, czy główne zdjęcie ma co najmniej 1200 px szerokości i gotowe kadry do udostępniania. Jeśli coś się nie zgadza, wpis czeka. Po publikacji zadanie odświeża blog i powiadamia wyszukiwarki przez IndexNow.
Do 27 października działało to na moim komputerze. Teraz działa na serwerze, bo publikacja nie powinna zależeć od tego, czy laptop jest włączony. Obecny plan to 16 wpisów między 6 listopada a 21 grudnia, jeden co trzy dni.
Kontrola SEO i linki wewnętrzne#
Skan serwisu z 4 listopada pokazuje, że części stron brakuje grafiki do udostępniania, a inne przejmują tytuł strony głównej. Next.js łączy metadane płytko, więc wystarczy, że jedna sekcja ustawi własne tagi Open Graph, i reszta po cichu znika. Teraz każda strona buduje metadane przez jedną funkcję pomocniczą, która zawsze zwraca komplet.
Linki wewnętrzne mają własne rundy. 4 listopada dochodzi 115 linków w 58 wpisach. 6 listopada kolejne 140 linków w 54 wpisach, wszystkie prowadzące do 50 artykułów, które Google zna, ale ich nie zaindeksował.
Wszystkie 50 przechodzi kontrolę techniczną. Mój roboczy wniosek: były po prostu słabo podlinkowane. Dopasowanie istniejących fraz znajduje tylko około 40 z mniej więcej 145 potrzebnych linków. Pozostałe wymagają nowego zdania-pomostu, dopisanego ręcznie do tekstu.
Poprawna polszczyzna#
Kurs, który uczy błędnego polskiego, jest gorszy niż brak kursu, więc tu idzie najwięcej uwagi.
6 października kontrola wszystkich lekcji, quizów i stron gramatyki przynosi 68 poprawek treści i dwa błędy w quizach. Kilka przykładów:
- Zamiast dwadzieścia jeden książek lekcja uczyła formy dwadzieścia jedna książka.
- Przykład akcentu przeczył regule, którą miał ilustrować.
- Biernik od one był podany jako ich zamiast je.
- Quiz z lukami przyjmował odpowiedzi bez polskich znaków nawet wtedy, gdy taka pisownia to inne, prawdziwe słowo. Te furtki znikają. Pod polem odpowiedzi pojawiają się za to przyciski ą, ć, ę, ł, ń, ó, ś, ź i ż.
Nagrania mają osobną kontrolę. Pierwszy głos, nagrany 7 listopada, zastępuje syntezator przeglądarki. Potem rodzima użytkowniczka polskiego przesłuchuje lekcje od 1 do 6 i znajduje realne problemy. Model zgadywał język, więc my, zero i komputer brzmiały po angielsku, a niektóre słowa kończyły się przeciągniętym „mmm”.
Wszystkie 744 kwestie zostają nagrane od nowa innym głosem, w modelu z wymuszonym językiem polskim. Ten głos wybiera ona sama spośród pięciu propozycji. Każde nagranie przechodzi przez polskie rozpoznawanie mowy, a nietrafione są nagrywane ponownie. Wiersze z dźwiękami, takimi jak sz czy rz, odtwarzają teraz przykładowe słowo, bo żaden głos nie wymówi dobrze samej głoski. Zasady redakcyjne serwisu mówią wprost, że nagrania to głos AI.
Ta sama zasada obowiązuje w wideo. Każda nowa polska kwestia w lekcji na YouTubie czeka na odsłuch przez rodzimą użytkowniczkę języka, zanim film trafi do harmonogramu.
Jak to monitoruję#
4 listopada powstaje Content Monitor, panel dla wszystkich moich serwisów z treścią. Dla PolishPal pokazuje:
- Wszystkie artykuły i harmonogram razem z zapasem, czyli liczbą dni zaplanowanych wpisów. Gdy w kolejce nic nie ma, pojawia się alert.
- Stan indeksacji w Google dla każdej strony, z API URL Inspection. Strony niezaindeksowane są sprawdzane ponownie po trzech dniach, zaindeksowane po 21.
- Ruch z Search Console, synchronizowany codziennie, oraz widok fraz z łatwymi celami na pozycjach 4–20.
- Crawler linków, który wyłapuje wpisy-sieroty, wpisy z mniej niż trzema linkami wewnętrznymi i martwe linki.
Alerty przychodzą na Telegram. Gdy nowy artykuł trafia do sieci, monitor od razu sprawdza jego indeksację, a potem codziennie przez dwa tygodnie. Wiadomość mówi, czy Google już go zaindeksował.
Jedna z pierwszych lekcji: nigdy nie wysyłać statusu z zapisanego wyniku. Testowa wiadomość podała, że wpis „nie jest zaindeksowany”, choć Google zaindeksował go kilka godzin wcześniej. Druga: 6 listopada Search Console przyjmuje tylko cztery ręczne prośby o indeksację, a przy piątej pokazuje „Quota exceeded”. Teraz takie prośby planuję po pięć dziennie.
Social media: Facebook i YouTube#
Posty powstają w paczkach i są planowane w Postizie. Strona PolishPal na Facebooku działa od 7 listopada.
Lekcje na YouTubie powstają z danych lekcji. Każdy film to zestaw scen ze scenariusza wyrenderowanych do wideo, z anglojęzycznym lektorem. Polskie kwestie korzystają z tych samych zatwierdzonych nagrań co serwis, więc kanał i kurs zawsze mówią to samo.
Lekcja 1 jest na kanale od 9 listopada i można ją obejrzeć na stronie lekcji, obok sekcji „Review in 30 seconds” z Shortsami. Lekcje 2–4 czekają w harmonogramie. Pilot kosztuje około 1,70 USD w kredytach na głos i wideo.
Wnioski: co warto robić od pierwszego dnia#
- Trzymać zdjęcia u siebie i je sprawdzać. Endpoint uploadu w CMS-ie tworzył pliki WebP, które zwracały kod 200, ale nie dało się ich zdekodować, więc przeglądarka pokazywała pusty obrazek. 2 listopada przegląd znajduje 12 brakujących zdjęć i 108 odwołań w 30 wpisach bez ścieżki do folderu. Teraz każde zdjęcie leży we własnym folderze /blog/ serwisu, skrypt dekoduje wszystkie po kolei, a harmonogram nie opublikuje wpisu z wadliwym plikiem.
- Wiedzieć, co potrafią podglądy. Ustawienia Supabase są tylko w środowisku produkcyjnym, więc każdy podgląd gałęzi wywraca się przy budowaniu. Zmiany widać dopiero po scaleniu. Z tą wiedzą to nie problem, bez niej to sporo zamieszania.
- Od początku używać dużych zdjęć. 59 opublikowanych wpisów miało główne zdjęcie węższe niż 1200 px, a grafiką do udostępniania była plansza z tekstem. Google zaleca dla Discover zdjęcia o szerokości co najmniej 1200 px. Poprawka wymaga nowych zdjęć, kadrów 16:9 dla wszystkich 132 wpisów i blokady w harmonogramie.
- Pilnować uczciwości stron o serwisie. Strona „O nas” mówiła „brak reklam”, choć blog po zgodzie wyświetlał reklamy. Poprawka wchodzi 8 listopada. Strony prawne i informacyjne rozjeżdżają się z serwisem po cichu, więc trzeba je sprawdzać przy każdej zmianie.
- Wcześnie wybrać licencję. PolishPal startował na CC0, czyli w domenie publicznej. 10 listopada przechodzi na „wszelkie prawa zastrzeżone”. CC0 nie da się cofnąć dla kopii, które ktoś już pobrał, więc dawny wybór nadal ich dotyczy.
- Nie linkować wpisu, zanim jest opublikowany. Jeśli ktoś otworzy adres przed publikacją, pamięć podręczna może trzymać stronę „nie znaleziono” nawet przez godzinę.
Co dalej#
Lista na najbliższe tygodnie jest krótka: kolejna runda fraz, nowe lekcje wideo w tempie około dwóch tygodniowo i podpis autora pod artykułami. Sposób pracy się nie zmienia: zapisać zasadę, sprawdzać ją automatycznie i naprawiać przyczynę, a nie objaw.